고정 헤더 영역
IPLEX · AI PATENT INSIGHTS
AI 기술은 쉽게,
특허 전략은 구체적으로.
AI 기술을 제품과 특허 권리로 연결해 설명하는 실무 블로그입니다. 인공지능 논문, AI 기업의 제품과 특허를 함께 분석하고 기술의 차별점을 출원 전략과 권리범위로 연결합니다.

상세 컨텐츠
본문
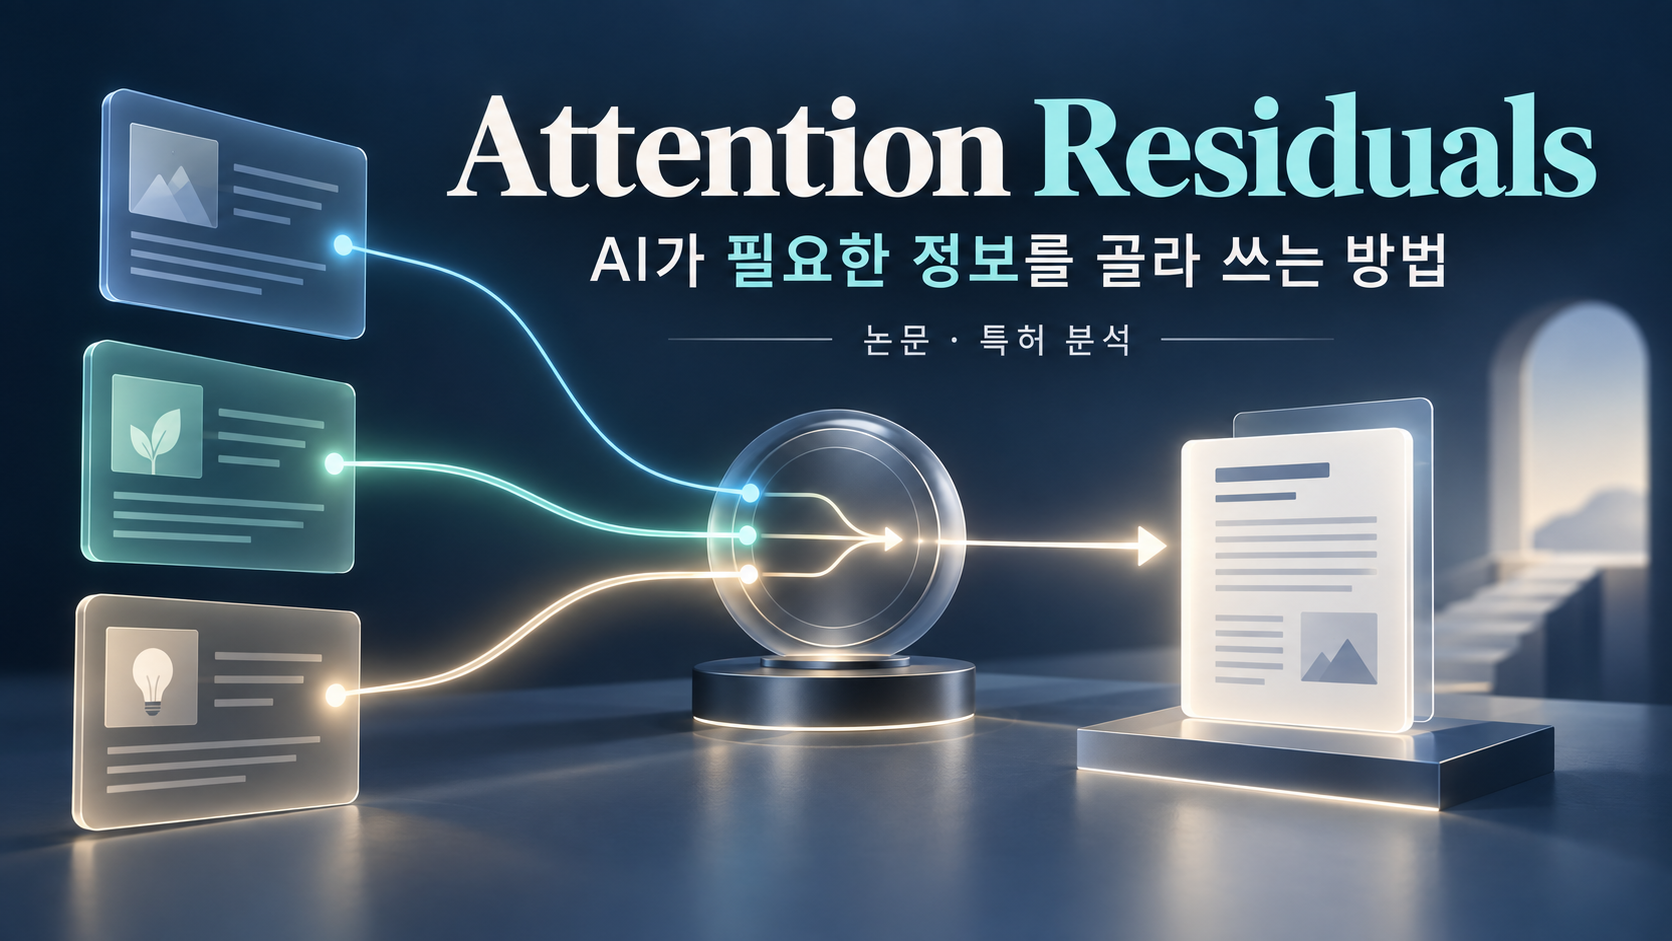
Attention Residuals는 AI가 앞선 처리 단계의 정보를 입력에 맞는 비율로 조합하는 연결 방식입니다. 모든 결과를 같은 비중으로 더하는 대신, 학습한 비교 기준으로 반영 비율을 정합니다. 이 글에서는 작동 원리를 쉬운 예로 살펴보고, AI 특허에서 검토할 기술적 차이를 정리해 드립니다.
분석 대상: Kimi Team의 Attention Residuals · 2026년 3월 16일 공개된 arXiv v1 기준
1. 앞 단계의 정보를 어떻게 전달할까요?
AI는 여러 처리 단계를 거치면서 입력을 해석합니다. 여기서 층은 정보를 처리하는 한 단계를 뜻합니다. 잔차 연결은 앞에서 전달받은 정보에 새 처리 결과를 더해 다음 단계로 보내는 연결입니다.
기존 연결에서는 앞선 결과들이 같은 비중으로 누적됩니다. 논문은 깊은 모델에서 개별 층의 기여가 희석되는 문제에 주목했습니다. Attention Residuals는 앞선 표현들을 비교하고, 입력에 따라 서로 다른 비율로 반영하도록 설계합니다.
어텐션은 여러 정보를 비교해 반영 비율을 정하는 방법입니다. 이 논문에서는 같은 토큰이 여러 층을 거치며 만든 표현을 비교합니다. 토큰은 글을 처리하기 위해 나눈 작은 단위입니다.
2. 보고서 메모로 이해해 보세요
세 사람이 보고서에 메모를 남겼다고 가정해 보겠습니다. 최종 작성자는 지금 고치는 문장에 도움이 되는 메모를 더 많이 참고할 수 있습니다. AI도 앞선 단계의 처리 결과를 입력에 맞는 비율로 조합합니다.
이해를 돕기 위한 가상 예시
메모 A10%적게 반영
메모 B20%일부 반영
메모 C70%더 많이 반영
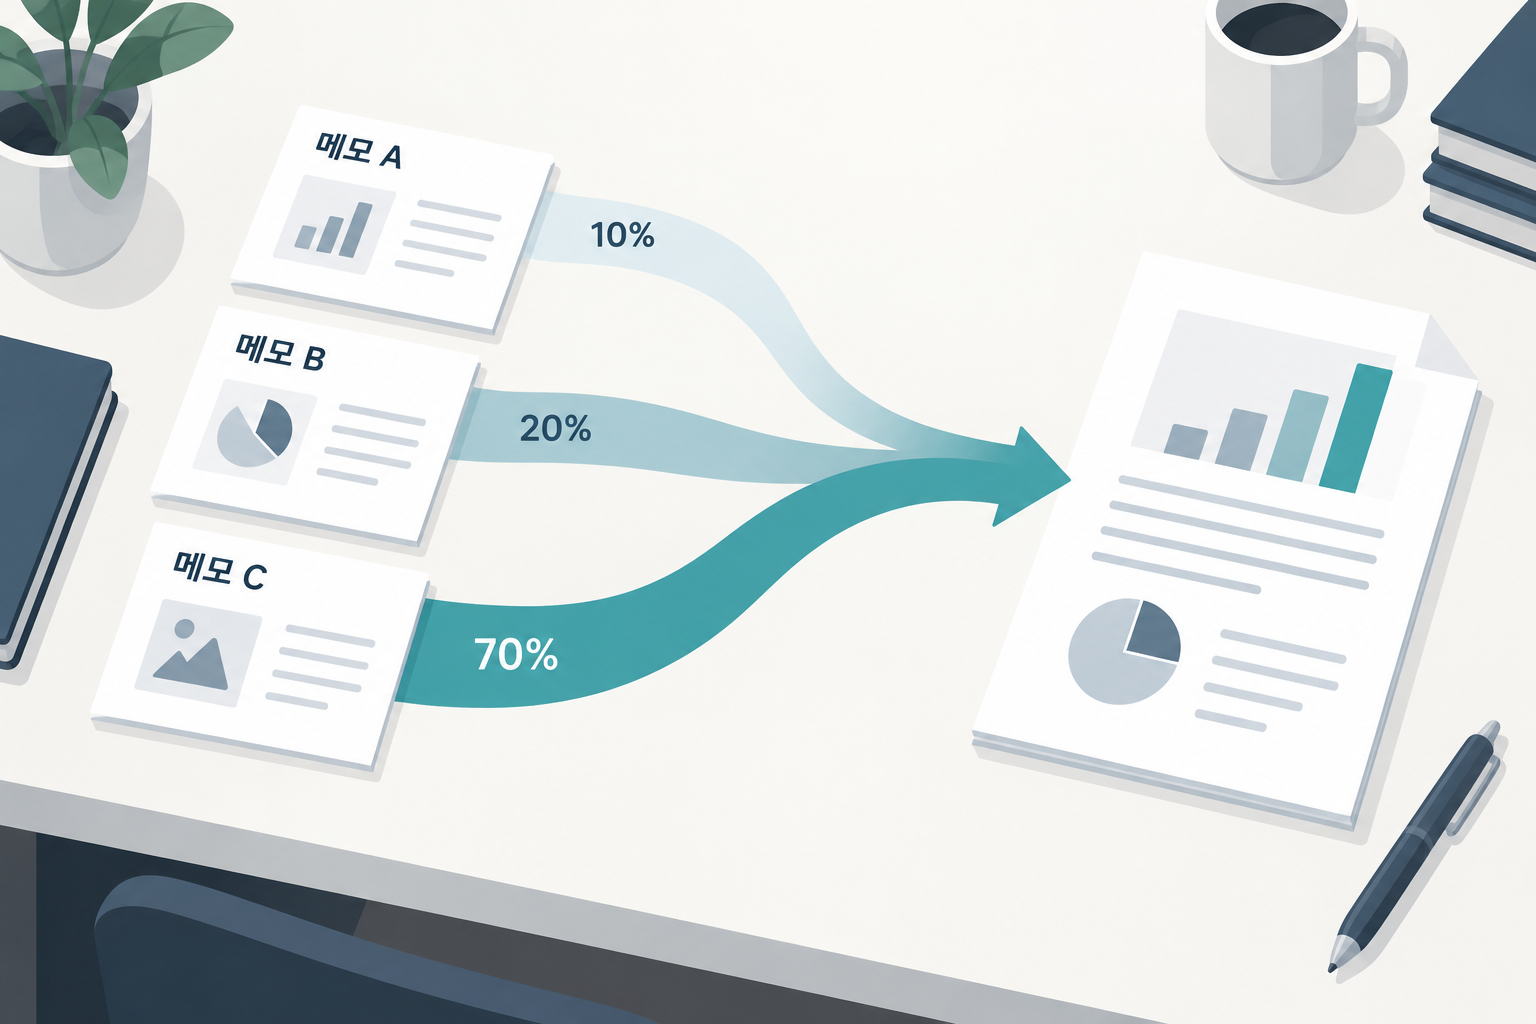
→ 다음 처리에 사용
위 숫자는 설명을 위한 예시이며 논문의 실험값이 아닙니다. 실제 모델에서는 처리 결과를 숫자의 묶음으로 나타내고, 학습한 비교 기준으로 반영 비율을 계산합니다. 사람이 메모의 중요도를 지정하는 방식은 아닙니다.
3. 세 단계로 살펴보는 작동 원리
- 앞선 결과를 모읍니다. 반영 비율을 계산할 때 사용할 표현의 크기를 정규화합니다. 정규화는 비교에 사용할 값의 크기를 일정한 기준에 맞추는 처리입니다.
- 반영 비율을 정합니다. 층마다 학습한 비교 기준으로 점수를 계산합니다. 소프트맥스는 여러 점수를 전체 비율의 합이 100%가 되도록 바꾸는 계산입니다.
- 결과를 조합합니다. 계산한 비율대로 원래의 표현을 합쳐 다음 처리의 입력으로 사용합니다.
모든 앞선 결과를 따로 보관하면 메모리와 통신 부담이 커질 수 있습니다. 논문은 여러 층을 묶는 Block AttnRes도 제안합니다. 묶음 안에서는 결과를 더하고, 묶음 사이에서는 어텐션으로 반영 비율을 정합니다. 이렇게 층을 묶어 관리해 모든 층의 결과를 따로 보관하는 방식의 저장·통신 부담을 줄입니다.
4. 실험에서 확인한 점과 적용 한계
저자들은 Kimi Linear 기반 모델을 학습한 뒤 일반 지식, 수학, 코드 등 여러 평가에서 개선을 보고했습니다. 이는 논문에 제시된 구조와 학습·평가 조건에서 얻은 결과입니다. 기존 모델의 연결만 바꾸면 같은 효과가 나온다고 해석하기는 어렵습니다.
제품과 연결해 생각한다면 기업용 보고서 요약 AI의 내부 구조를 검토하는 예를 들 수 있습니다. 이때 요약 품질뿐 아니라 앞선 결과를 저장하는 메모리, 장치 사이 통신량, 처리 시간도 함께 측정해야 합니다. 이는 적용 가능성을 설명하기 위한 예시이며, 특정 시판 제품이 이 기술을 사용한다고 확인한 내용은 아닙니다.
5. 아이피렉스의 AI 특허 검토 포인트
이 절은 공개 논문에 대한 독립적인 특허 실무 검토입니다. 특정 등록특허의 권리범위를 분석하거나 등록 가능성을 확정한 내용은 아닙니다.
청구항은 특허로 보호받으려는 범위를 정리한 문장입니다. 이런 기술을 검토할 때는 정보를 선택한다는 목표를 구체적인 처리 구성과 연결해 살펴봐야 합니다.
- 선택 대상: 개별 층의 출력인지, 여러 층을 묶은 표현인지 확인합니다.
- 비율 계산: 학습한 비교 기준, 정규화, 비율 계산이 어떤 순서로 결합되는지 살펴봅니다.
- 저장·전송: 앞선 결과를 보관하고 중복 전송을 줄이는 구성과 처리 순서를 확인합니다.
- 기술적 효과: 구성 변경이 성능·메모리·통신량에 미치는 영향을 비교 조건과 함께 정리합니다.
AI 특허를 준비하신다면 처리 흐름도, 기존 방식과 달라진 구성, 비교 실험 자료, 기술 공개 일정을 정리해 주세요. 아이피렉스는 공개된 AI 분야 특허 분석·IP-R&D 프로젝트와 관련 저서를 바탕으로 기술의 차이를 권리 설계 관점에서 검토합니다. 구체적인 이력은 김용덕 대표 변리사의 공식 프로필에서 확인하실 수 있습니다.
원문과 함께 읽으면 좋은 글
- Attention Residuals 논문 서지정보 · v1
- 논문 본문과 실험 조건
- 연구진의 공식 설명
- In-Place Test-Time Training: 추론 중 가중치를 바꾸는 또 다른 접근
- 아이피렉스의 AI·소프트웨어 특허 업무와 상담 안내
분석 기준: 2026년 10월 3일 · arXiv v1 · 실험은 독립적으로 재현하지 않았습니다.
'AI 논문 분석' 카테고리의 다른 글
| FlashAttention-2 논문 쉽게 읽기: 긴 글의 어텐션을 GPU에서 빠르게 계산하는 원리 (0) | 2026.10.07 |
|---|---|
| 추론 중 가중치를 바꾸는 LLM: In-Place Test-Time Training 논문·특허 분석 (0) | 2026.08.05 |


